Trascrizione manuale
Ore ogni settimana a copiare date, importi, codici e righe di tabella da un PDF a un foglio Excel.
Ogni fattura, bolla o modulo ricopiato a mano costa minuti, e ogni errore di battitura costa di più. Sviluppo pipeline OCR e AI che leggono documenti anche scansionati o storti, estraggono i campi che ti servono e li portano in Excel, nel gestionale o in un database, con controlli automatici.
Sono le situazioni da cui partono quasi tutti i progetti di OCR e Document AI. Ognuna ha un costo, in ore e in errori.
Ore ogni settimana a copiare date, importi, codici e righe di tabella da un PDF a un foglio Excel.
Ogni fornitore usa un modello diverso: le regole fisse e i convertitori classici non bastano.
Un importo o una partita IVA sbagliati generano verifiche, ritardi e contestazioni.
Estrazione di dati da PDF, fatture, ricevute e scansioni, con risultati organizzati per le elaborazioni successive.
Come esperto OCR e Document AI, combino riconoscimento del testo e modelli linguistici per trasformare documenti non strutturati in dati utilizzabili. Il progetto parte da un campione rappresentativo dei formati, delle qualità e dei contenuti da gestire.
Definiamo i campi da estrarre, il formato di uscita e i controlli necessari. La soluzione può lavorare su raccolte di file, integrarsi in una pipeline esistente o, quando i requisiti lo permettono, funzionare direttamente su un dispositivo.
OCR su scansioni e fotografie, con preelaborazione per migliorare la leggibilità.
Identificazione di campi, tabelle e metadati, con normalizzazione dei risultati.
Esportazione in Excel, JSON, CSV o altri formati concordati.
Leggere il testo è soltanto un passaggio: un documento deve anche essere interpretato, organizzato e controllato. I servizi qui sotto coprono estrazione di campi e tabelle, fatture, archivi e OCR su dispositivi. Ogni pagina approfondisce ingressi, risultati e condizioni di utilizzo.
Sviluppo strumenti che trasformano raccolte di PDF in fogli Excel utilizzabili. Definiamo quali informazioni recuperare, come organizzare le colonne e quali controlli applicare, così il risultato entra nel tuo lavoro quotidiano senza un nuovo passaggio di trascrizione.
Trasformo fatture e documenti contabili ricevuti in record strutturati. Il lavoro comprende lettura dei campi, gestione delle righe, controlli e formato di uscita, con una revisione esplicita dei casi che non possono essere trattati in modo affidabile.
Sviluppo pipeline per trasformare raccolte di scansioni e documenti in archivi ordinati e consultabili. Il lavoro può includere riconoscimento del testo, metadati, classificazione e formati di esportazione, mantenendo il collegamento con le immagini e i file di origine.
Porto il riconoscimento del testo sul dispositivo, quando hardware e requisiti lo consentono. Progetto acquisizione, elaborazione ed estrazione dei campi per applicazioni che devono leggere documenti senza dipendere da una richiesta cloud a ogni scansione.
Sviluppo componenti che recuperano la struttura dei documenti, oltre al semplice testo. Tabelle, etichette e valori diventano record collegati, con regole per celle unite, righe spezzate e campi mancanti, in un formato utilizzabile dai tuoi programmi.
Obiettivi, dati e strumenti cambiano da un progetto all’altro. Il lavoro parte dal processo che vuoi migliorare e viene adattato alle condizioni in cui la soluzione sarà utilizzata.
Estraggo i campi concordati e li trasformo in record coerenti: riferimenti, date, importi e righe di dettaglio. Definisco controlli su formati e relazioni fra valori, collegando ogni risultato al documento di origine per consentire una verifica delle informazioni.
Ricostruisco la struttura di tabelle e campi anche quando le informazioni sono distribuite su più pagine. L’output può essere un Excel, un JSON o un database. La gestione dei file multipli comprende identificativi, stato dell’elaborazione e casi da rivedere.
Preparo immagini con rotazione, rumore o prospettiva e valuto i modelli sui materiali effettivi. Quando il progetto richiede esecuzione offline o mobile, considero dimensioni del modello, risorse del dispositivo e formati supportati prima di scegliere l’architettura.
Una soluzione documentale deve produrre dati utilizzabili e rendere visibili le eccezioni. Posso consegnare un’elaborazione batch, un’API o un’applicazione con caricamento, revisione ed esportazione, secondo il flusso previsto.
Invia un campione con le diverse tipologie di documento e un esempio del risultato desiderato. Sono utili anche i file meno leggibili, le lingue presenti, i volumi attesi e le regole con cui oggi una persona controlla i dati.
Gli obiettivi vengono misurati sui tuoi dati e condivisi a ogni milestone, così sai sempre cosa sta producendo il progetto.
Casi del mio lavoro per approfondire il problema affrontato, lo sviluppo e i risultati.
Un backend per compilare documenti Word e PDF destinati a bandi di gara e appalti, partendo dal modello da completare e dai dati aziendali in JSON. Ho sviluppato l’orchestrazione degli agenti con modelli Mistral, l’archiviazione in MariaDB e il collegamento al frontend dell’azienda. Il sistema è operativo su infrastruttura Azure in Europa e viene utilizzato ogni giorno per decine di documenti.
Leggi il progetto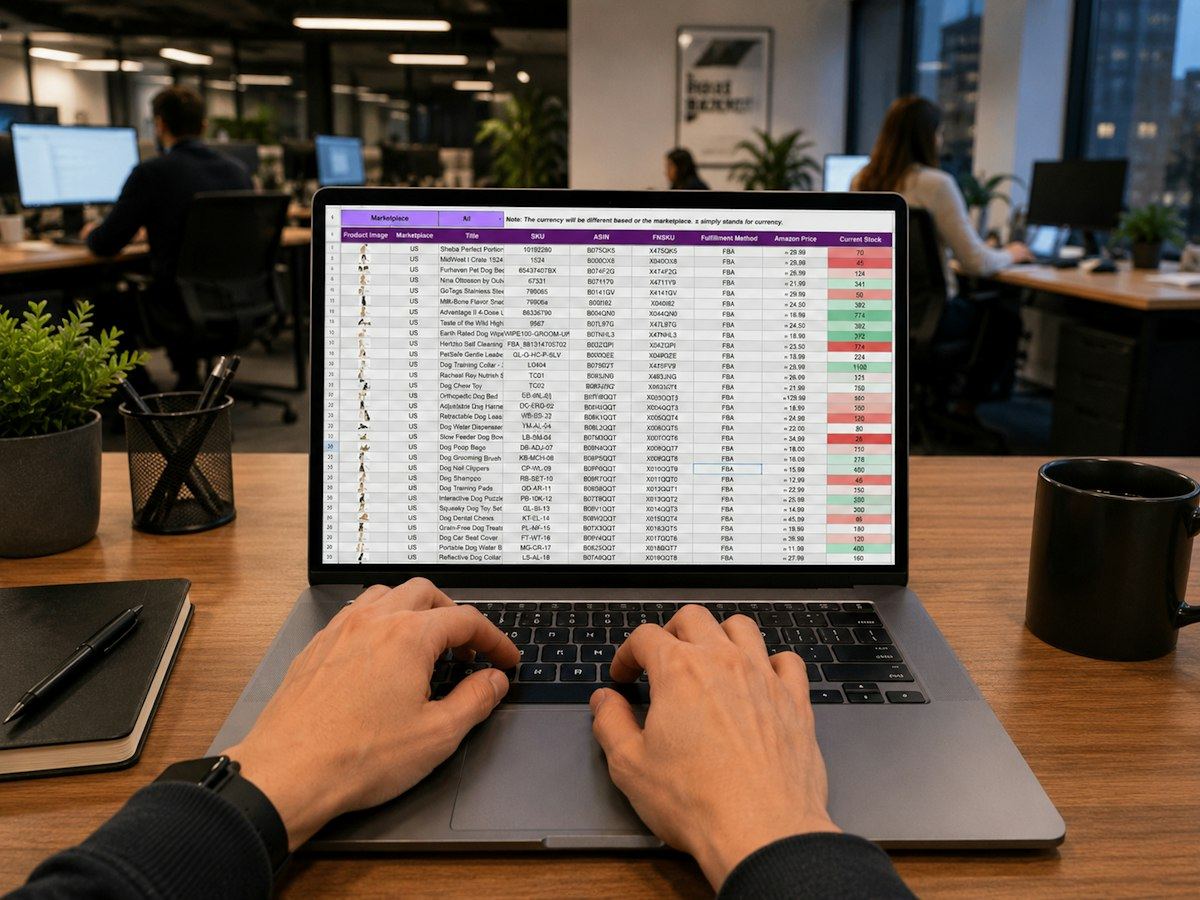
Una pipeline interamente open source per individuare e correggere difetti nelle tabelle di documenti PDF: testo sovrapposto, contenuti fuori dalle celle, linee irregolari e caratteri troppo grandi. Ho combinato Computer Vision, OCR e confronto di embedding, con elaborazione di centinaia di file e un’interfaccia per la revisione manuale.
Leggi il progetto
Un progetto di riconoscimento della scrittura manuale in ebraico e di formule matematiche con numeri complessi, presenti su lavagne e tablet. Dopo il confronto delle soluzioni esistenti, ho annotato i dati del cliente e adattato un modello PaddleOCR preaddestrato, raggiungendo un’accuratezza intorno al 96% nelle valutazioni del progetto.
Leggi il progetto
Una soluzione operativa per leggere le targhe dei veicoli in corrispondenza di caselli e portali autostradali. Ho addestrato e collegato più modelli in cascata per individuare la targa, riconoscerne il Paese o il formato e interpretare i caratteri con OCR.
Leggi il progetto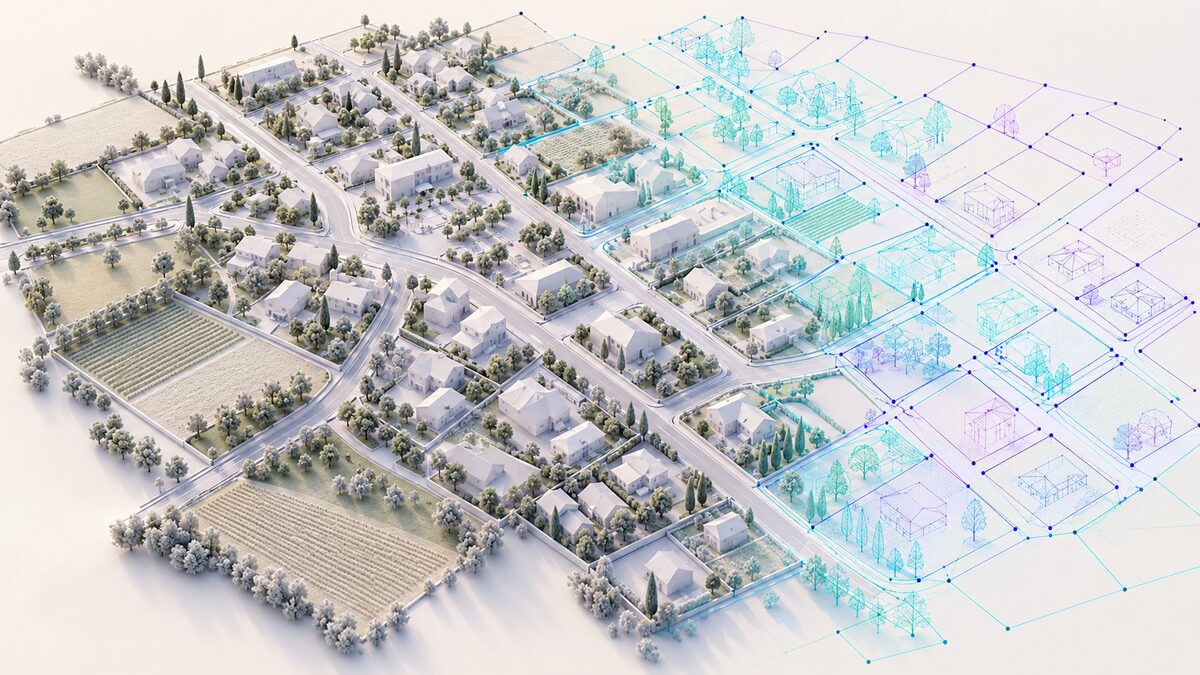
Ho sviluppato una pipeline per trasformare PDF scansionati e fotografie di planimetrie territoriali in file DXF modificabili in AutoCAD. Il sistema combina Computer Vision, OCR e ricostruzione geometrica per recuperare strade, edifici, pareti, vertici, bearing e misure in metri. Il progetto, realizzato nell’ottobre 2025, è stato consegnato come applicazione web e desktop, con codice open source ed esecuzione sull’infrastruttura del cliente.
Leggi il progettoUna pipeline che legge fatture e documenti tecnici, riconosce i campi utili e li trasforma in file Excel strutturati.
Leggi il progetto
Un motore OCR per elaborare ricevute su Android senza inviare i documenti a servizi cloud.
Leggi il progetto
Un sistema Python per trasformare le scansioni del dizionario Zingarelli del 1922 in un archivio strutturato e utilizzabile per la ricerca.
Leggi il progettoAnalizzo qualità, lingue, strutture e varianti dei file. Concordiamo i campi da estrarre, i formati di uscita e come trattare valori assenti, documenti illeggibili e informazioni non presenti nel testo.
Combino preprocessing, riconoscimento e regole applicative. Quando necessario adatto un modello ai dati disponibili, verificando separatamente lettura del testo, ricostruzione delle tabelle ed estrazione dei campi.
Confronto i risultati con esempi verificati, preparo gli output e collego il flusso agli strumenti concordati. La revisione manuale, quando prevista, consente di correggere i casi incerti prima dell’utilizzo successivo.
Non trovi la tua domanda? Scrivimi o prenota una call gratuita di 30 minuti.
Sì. Le pagine vengono raddrizzate e pulite prima dell’OCR, e i campi sono riconosciuti anche su scansioni di qualità media.
No. Il sistema interpreta layout diversi combinando OCR e modelli linguistici, senza dover configurare un modello per ogni fornitore.
Sì, tramite API, file di importazione o database, in base a cosa supporta il gestionale. In alternativa produco file Excel pronti da importare.
Ogni campo può avere un livello di confidenza: i valori incerti vengono segnalati per una verifica rapida invece di finire nel risultato senza controllo.
Sì. La pipeline può girare in locale o su server europei, senza inviare i documenti a servizi esterni.
Parti dal livello di impegno che preferisci: una call gratuita, un MVP sui tuoi dati o la soluzione completa.
Gratuita30 minuti
Il primo passo, senza impegno: capiamo insieme se e come l’AI può risolvere il tuo problema.
da 500 €in 10 giorni lavorativi
Vedi la soluzione funzionare su un campione reale dei tuoi documenti, immagini o dati prima di investire nel progetto completo.
da 1.500 €in 3–6 settimane
Sviluppo completo, test e integrazione negli strumenti che usi già, con milestone verificabili.
Prezzi IVA esclusa. Il preventivo definitivo dipende da volumi, integrazioni e qualità dei dati, ed è sempre concordato prima di iniziare. Come proteggo i tuoi dati.
Descrivimi cosa vuoi ottenere e quali dati hai a disposizione. La prima call di 30 minuti è gratuita.