Documenti non strutturati
PDF scansionati e documenti tecnici con impaginazioni, strutture e qualità di scansione differenti.
Questo progetto realizza un prototipo AI capace di estrarre dati strutturati da fatture PDF e documenti tecnici combinando OCR e analisi con LLM. Il sistema converte file non strutturati in dataset Excel puliti e affidabili, pronti per la contabilità o le successive automazioni.
L’estrazione manuale dai PDF è lenta, poco uniforme e soggetta a errori.
I documenti differiscono per layout, struttura e qualità, rendendo poco affidabile l’analisi tradizionale basata su regole.
Il cliente aveva bisogno di una soluzione leggera e automatizzata per leggere fatture, individuare i campi principali ed esportare i risultati in un formato uniforme, senza interventi manuali.
Ho sviluppato una pipeline OCR e LLM in Python che legge PDF scansionati, individua campi come nomi, identificativi, date, totali e imposte ed esporta i risultati in un file Excel strutturato.
Il sistema utilizza l’analisi con GPT per gestire le variazioni del layout e supera il 90% di precisione nell’estrazione nei test interni.
Il prototipo funziona su una GPU cloud ed è progettato per estensioni future a nuovi formati documentali.
PDF scansionati e documenti tecnici con impaginazioni, strutture e qualità di scansione differenti.
Estrazione e pulizia del testo, quindi identificazione di nomi, codici, date, importi e imposte mediante LLM.
Campi normalizzati in un file Excel uniforme, utilizzabile per controlli contabili ed elaborazioni successive.
Schema descrittivo del flusso di lavoro del progetto.
2 fasi, dalla preparazione iniziale agli strumenti da consegnare.
Un sistema OCR personalizzato che elabora fatture PDF, estrae il testo dalle immagini, individua i campi principali e pulisce i dati grezzi. Fornisce testo di alta qualità, pronto per l’analisi con LLM
Un modulo intelligente di post elaborazione che utilizza GPT per identificare nomi, identificativi, date, totali e imposte ed esporta i risultati in un file Excel pulito e strutturato, con elevata precisione.
Il progetto realizza un sistema completo e automatizzato per estrarre dati strutturati da fatture e PDF tecnici attraverso OCR avanzato e analisi con GPT. Tutti i documenti vengono convertiti in risultati Excel puliti e affidabili, pronti per l’impiego nei flussi contabili.
Il modulo OCR garantisce un’estrazione del testo accurata anche con layout diversi, mentre il livello LLM interpreta i campi, verifica i valori e risolve le incongruenze. Il risultato è un prototipo robusto che trasforma PDF non strutturati in dataset organizzati e pronti per l’elaborazione automatica.
La soluzione offre una solida base per sviluppi futuri, tra cui il supporto a più formati, OCR multilingue e un’automazione più ampia dell’elaborazione dei documenti finanziari.
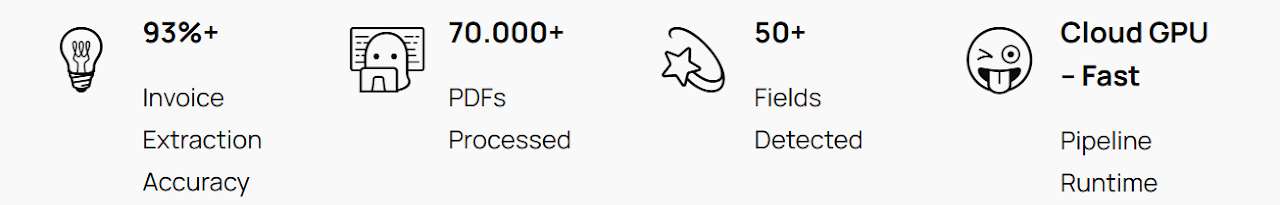
Le prestazioni riportate descrivono i risultati indicati nella scheda originale e i dati di quel progetto. Accuratezza e tempi di elaborazione dipendono da dataset, hardware e condizioni di test.
>90%errori individuati
Rilevamento e correzione dei difetti nelle tabelle PDF
≈96%accuratezza raggiunta
OCR ebraico e formule matematiche su lavagne e tablet
Descrivimi cosa vuoi ottenere e quali dati hai a disposizione. La prima call di 30 minuti è gratuita.