Raccolta dell’archivio
Documenti acquisiti da più fonti e organizzati in un insieme coerente di PDF, file Word e immagini.
Una raccolta di documenti diventa una base di conoscenza interrogabile. Dalla raccolta dei file alla ricerca in linguaggio naturale.
Le grandi organizzazioni gestiscono migliaia di documenti tecnici, tra PDF, file Word, immagini e report scansionati. Estrarre informazioni strutturate, cercare nei documenti e ricavare indicazioni manualmente è un processo lento, costoso e soggetto a errori. Il cliente aveva bisogno di un flusso completamente automatizzato capace di:
Raccogliere documenti originali da più fonti
Convertirli in dataset puliti e affidabili
Estrarre testo, tabelle e informazioni strutturate
Consentire ricerche e analisi in linguaggio naturale su tutti i file
Ho sviluppato una pipeline completa di intelligenza documentale AI che combina automazione, OCR, NLP e RAG. Il sistema raccoglie automaticamente i documenti, estrae il testo spagnolo con elevata precisione, pulisce e normalizza i dati e permette agli utenti di interrogare migliaia di file in linguaggio naturale attraverso LLM avanzati.
La precisione dell’OCR e del recupero delle informazioni RAG supera il 95% grazie a dizionari di settore personalizzati, regole di pulizia del testo e verifiche dell’affidabilità articolate in più fasi.
Documenti acquisiti da più fonti e organizzati in un insieme coerente di PDF, file Word e immagini.
OCR con dizionario tecnico spagnolo, filtri di affidabilità e normalizzazione di testo, tabelle e metadati.
Indicizzazione e recupero delle informazioni per supportare ricerche in linguaggio naturale, interrogazioni e riepiloghi con LLM.
Schema descrittivo del flusso di lavoro del progetto.
3 fasi, dalla preparazione iniziale agli strumenti da consegnare.
Sistema automatizzato che esamina le cartelle, recupera PDF, file Word e immagini, uniforma i formati e organizza i contenuti in un dataset pulito e strutturato. Prepara tutti i documenti per le successive fasi di elaborazione OCR e AI.
Pipeline OCR personalizzata con dizionario tecnico spagnolo, filtri di affidabilità e logiche di pulizia dei dati. Estrae testo, tabelle e metadati con elevata precisione ed esporta risultati strutturati in JSON, CSV e TXT per le successive elaborazioni AI.
Un sistema completo di generazione supportata dal recupero delle informazioni che indicizza tutti i documenti e consente ricerche in linguaggio naturale, interrogazioni intelligenti e riepiloghi automatici. Gli utenti possono porre domande, ricavare informazioni e consultare grandi raccolte documentali con una precisione adatta all’uso aziendale.
Il progetto realizza un sistema completamente automatizzato, adatto all’uso aziendale, per l’elaborazione dei documenti, l’estrazione OCR e la ricerca intelligente. Tutti i documenti, inclusi PDF, file Word e immagini, vengono puliti, normalizzati e convertiti in dataset strutturati. Il motore OCR personalizzato garantisce elevata precisione sul linguaggio tecnico spagnolo, mentre il livello RAG e LLM permette ricerche in linguaggio naturale, interrogazioni intelligenti ed estrazione immediata delle informazioni.
Il risultato è un flusso completo e scalabile che trasforma migliaia di documenti non strutturati in informazioni consultabili e utilizzabili nelle attività operative.
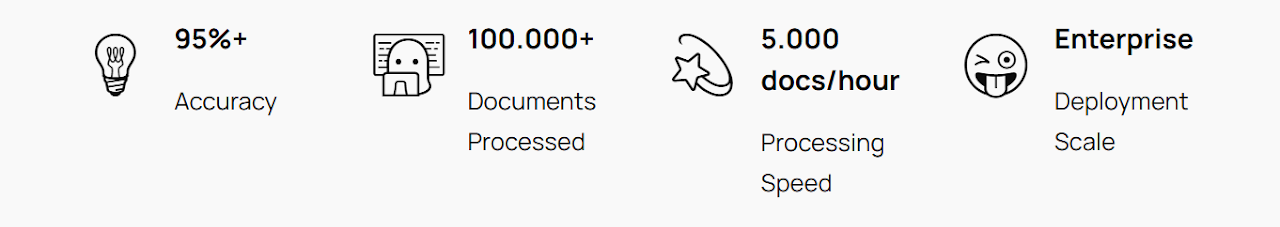
Le prestazioni riportate descrivono i risultati indicati nella scheda originale e i dati di quel progetto. Accuratezza e tempi di elaborazione dipendono da dataset, hardware e condizioni di test.
Centinaia di migliaiaarticoli scientifici consultabili
Chatbot AI per la ginecologia con RAG e fonti scientifiche
Decine/giornodocumenti compilati
Compilazione automatica di documenti per bandi e gare
Descrivimi cosa vuoi ottenere e quali dati hai a disposizione. La prima call di 30 minuti è gratuita.